
・異なる実験で得られたデータを揃える際、本来知りたい疾患や治療による違いまで消してしまうことが、細胞の解析における課題となっていた。
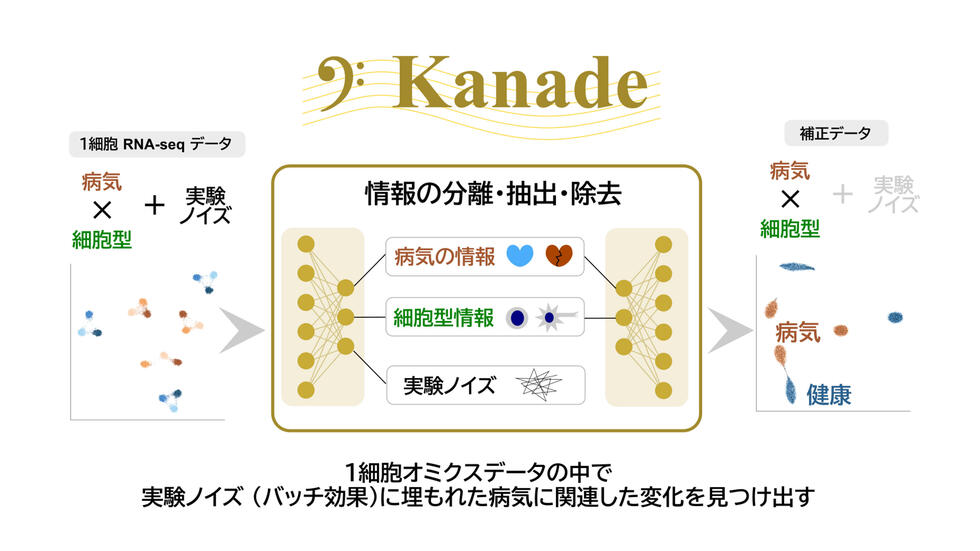
・「実験によるばらつき」「疾患や処置による違い」「細胞型による違い」を分けて学習し、実験由来の情報だけを選択的に取り除く機械学習法「Kanade」を開発した。
・シミュレーションとマウス膵臓の実データで性能を検証し、実験ごとのばらつきを補正しながら、疾患に関連する細胞状態の違いを保持できることを確認した。
・補正後の遺伝子発現量を再構成できるため、細胞の分類や可視化に加え、疾患に関連する遺伝子の探索など、その後の解析にも利用できる。
名古屋大学大学院医学系研究科の坂口峻太特任助教、堤真人特任助教(現・筑波大学生存ダイナミクス研究センター助教)、名古屋大学大学院医学系研究科の本田直樹教授(兼任:広島大学大学院統合生命科学研究科特任教授)らの研究グループは、1つ1つの細胞の遺伝子の働きを調べたデータから、「実験ごとのばらつき」と「比較したい生物学的な違い」を分離する、新しい機械学習法「Kanade」を開発しました。
1つ1つの細胞で、どの遺伝子がどの程度働いているかを網羅的に測定する「1細胞RNAシーケンシング(scRNA-seq)」は、疾患や治療による細胞の変化を調べるための重要な技術です。しかし、異なる実験で取得したデータには、測定装置、試薬、実験者などの違いによる技術的なばらつきが含まれます。このような「バッチ効果」を取り除こうとすると、本来知りたかった疾患や治療による違いまで、一緒に消してしまうことがあります。特に、健常群と疾患群などが別々の実験で測定されている場合、実験ごとのばらつきと条件間の生物学的な違いを区別することが難しくなります。条件間の比較は科学の根幹であるため、両者を分離し、バッチ効果のみを補正する手法が必要でした。
Kanade は、深層生成モデルの一種である変分オートエンコーダーを基盤として、遺伝子発現データに含まれる情報を、実験上のばらつき、疾患や処置などの条件による違い、細胞型の違いに分けて学習します。そして、実験由来の情報だけを取り除き、生物学的な特徴を保った遺伝子発現データを再構成します。データを単に似た形にそろえるのではなく、「消したい違い」と「残して比較したい違い」を区別して扱うことが、この手法の特徴です。
Kanade をシミュレーションデータに適用した結果、実験ごとの技術的な違いを取り除きながら、疾患や処置に関連する細胞の特徴を保持できることが示されました。さらに、実際の糖尿病モデルマウスの膵臓データを用いた解析でも、バッチ効果を補正した後も、糖尿病に関連する細胞状態の変化を捉えることができました。
また、Kanadeは補正後の遺伝子発現量そのものを出力できるため、細胞の分類や可視化だけでなく、疾患に関連する遺伝子の探索などにも利用できます。今後、異なる実験や研究施設で取得されたデータを、生物学的に重要な違いを保ちながら比較・統合するための解析基盤へと発展することが期待されます。
本研究成果は、2026年10月10日国際学術雑誌『Patterns』に掲載されました。
◆詳細(プレスリリース本文)はこちら
◆詳細(プレスリリース英文)はこちら
雑誌名:Patterns
論文タイトル:Disentangling batch effects and biological signals across conditions in single-cell transcriptome
著者:坂口峻太(名古屋大学大学院 医学系研究科)、堤真人(筑波大学 生存ダイナミクス研究センター)、西健太郎(広島大学大学院 統合生命科学研究科)、本田直樹(名古屋大学大学院 医学系研究科、広島大学大学院 統合生命科学研究科、名古屋大学 One Medicine生命-創薬共創プラットフォーム)
DOI: 10.1016/j.patter.2026.101638
URL: https://doi.org/10.1016/j.patter.2026.101638
大学院医学系研究科 データ駆動生物学 本田 直樹 教授/ 坂口 峻太 特任助教
https://sites.google.com/view/data-driven-biology/